Lebendiger Code: Refactoring der Biologie und synthetische Logik im CRISPR-Zeitalter
Ein softwaretechnischer Blick auf das quaternäre (A-T-G-C) Betriebssystem des Lebens: Genetische Bugs, CRISPR-Cas9 als molekulare Regex-Engine und biologische Logikgatter.
Einleitung: Das quaternäre Betriebssystem
Als Softwareentwickler oder Hardware-Ingenieure wissen wir beim Blick auf den Bildschirm, dass sich auf fundamentaler Ebene alles auf zwei Zustände reduzieren lässt: Spannung liegt an oder nicht; 1 oder 0. Die gesamte monumentale Architektur unserer Siliziumwelt, von Cloud-Rechenzentren bis zu den Mikrocontrollern in unserer Tasche, basiert auf dieser binären Logik. Doch wenn wir den Laborkittel anziehen und durch das Mikroskop blicken, stellen wir fest, dass die Natur seit knapp vier Milliarden Jahren eine weitaus ausgefeiltere Architektur betreibt: ein chemisches Betriebssystem auf quaternärer (Basis-4) Grundlage.
Der Quellcode der Biologie, die DNA, verwendet anstelle von 0 und 1 vier Nukleotidbasen: Adenin (A), Thymin (T), Guanin (G) und Cytosin (C).
Häufig wird DNA fälschlicherweise als passive Festplatte oder schreibgeschützte (Read-Only) Datenbank verstanden, die lediglich Erbinformationen vorhält. Betrachtet man das System jedoch aus ersten Prinzipien (First Principles), ergibt sich ein grundlegend anderes Bild: Die Zelle ist ein selbstkompilierendes, sich selbst replizierendes Programm. Sie liest ihren Quellcode (Transkription), transformiert ihn in einen intermediären Bytecode (mRNA) und übersetzt diesen über molekulare Compiler namens Ribosomen in dreidimensionale, funktionelle Nanomaschinen (Translation).
Darüber hinaus ist die Informationsdichte dieses biologischen Speichers mit Silizium nicht annähernd vergleichbar: Ein einziges Gramm DNA kann theoretisch rund 215 Petabyte (215 Millionen Gigabyte) an Daten speichern und diese unter geeigneten Bedingungen über Jahrtausende hinweg ohne jegliche Energiezufuhr fehlerfrei konservieren.
Genetische Bugs und Mutationen
Keine Software läuft auf Dauer ohne Fehler; in einer Codebasis von 3,2 Milliarden Basenpaaren (dem menschlichen Genom) sind Fehler während der Replikation oder Transkription mathematisch unvermeidbar. Das Phänomen, das wir in der Biologie als Mutation bezeichnen, entspricht exakt dem Begriff eines Bugs in der Softwareentwicklung.
Klassifizieren wir diese molekularbiologischen Fehler aus der Sicht eines Software-Ingenieurs:
- Syntaxfehler und Punktmutationen: Der Austausch eines einzelnen Zeichens im Code (z. B.
Aanstelle vonT) erzeugt eine Punktmutation (Single Nucleotide Polymorphism - SNP). Die Sichelzellanämie resultiert aus genau einem solchen Tippfehler: Der Austausch einer einzigen Base im Hämoglobin-Gen verändert die gesamte dreidimensionale Faltung des resultierenden Proteins. - Leserasterverschiebungen (Frameshift) und “Off-by-One”-Fehler: Das Ribosom liest den Code in Dreierblöcken (Codons) ein (
ATG-CGA-TTC...). Die Insertion oder Deletion einer einzelnen Base verschiebt das gesamte nachfolgende Leseraster. Wie bei einer fehlerhaften Zeigerarithmetik (Pointer Corruption) degenerieren alle nachfolgenden Codons zu Datenmüll (Garbage Data), was typischerweise in einem verfrühtenSTOP-Codon und dem Abbruch des Programms mündet. - Laufzeitfehler und epigenetische Fehlregulation: Zuweilen ist der Quellcode (die DNA-Sequenz) fehlerfrei; die statische Syntaxprüfung besteht ohne Warnung. Zur Laufzeit (Runtime) führen jedoch Umwelteinflüsse oder fehlerhafte Methylierungsmuster dazu, dass das richtige Gen zur falschen Zeit oder in falscher Dosierung exprimiert wird. Viele Krebsarten entstehen nicht primär durch syntaktische Codefehler, sondern durch zelluläre Routinen, die in einer Endlosschleife (
while(true)) gefangen sind und ihre Abbruchbedingung (break/ Apoptose) verloren haben.
💡 Ingenieurnotiz: Die Evolution betrachtet diese Kopiervorgänge nicht als bloße Fehler, sondern als kontinuierlichen planetaren A/B-Test. Die meisten Bugs bringen das System zum Absturz, doch die eine erfolgreiche Mutation unter Millionen verleiht dem Organismus in der Produktivumgebung (der Natur) einen entscheidenden Wettbewerbsvorteil.
CRISPR-Cas9: Molekulares Patching und Regex-Suche
Über Jahrzehnte konnten Molekularbiologen diese gigantische Codebasis lediglich sequenzieren (“Lesen”) oder mit groben chemischen Mutagenen manipulieren. Dies änderte sich grundlegend mit der Entdeckung und Nutzbarmachung von CRISPR-Cas9 – einem antiviralen Immunsystem von Bakterien –, das zu einem universellen Gen-Editor umfunktioniert wurde.
Die treffendste Analogie für CRISPR-Cas9 ist die “Suchen & Ersetzen”-Funktion (Find & Replace) einer modernen Entwicklungsumgebung oder die Unix-Befehle grep und sed:
- gRNA (Guide-RNA) — Die Regex-Suchabfrage: Eine Sequenz von ca. 20 Basen, die exakt definiert, an welcher Stelle im 3,2-Milliarden-Zeichen-Genom die Änderung erfolgen soll. Sie fungiert wie ein regulärer Ausdruck (Regular Expression) mit maximaler Spezifität.
- PAM-Sequenz (Protospacer Adjacent Motif) — Zugriffskontrolle: Damit die Cas9-Endonuklease binden und schneiden kann, muss unmittelbar neben der Zielsequenz ein Signaturmotiv wie
NGGvorhanden sein. Dies verhindert als molekulare Prüfsumme, dass das Bakterium versehentlich seine eigene CRISPR-Bibliothek zerschneidet. - Cas9-Enzym — Molekulare Schere und Patch-Tool: Sobald die gRNA hybridisiert, schneidet Cas9 beide Stränge der DNA (Doppelstrangbruch / Double-Strand Break). Indem man die zelleigenen Reparaturpfade (NHEJ oder HDR) nutzt, lässt sich das defekte Gen deaktivieren (auskommentieren) oder eine synthetische DNA-Matrize als Hot-Patch integrieren.
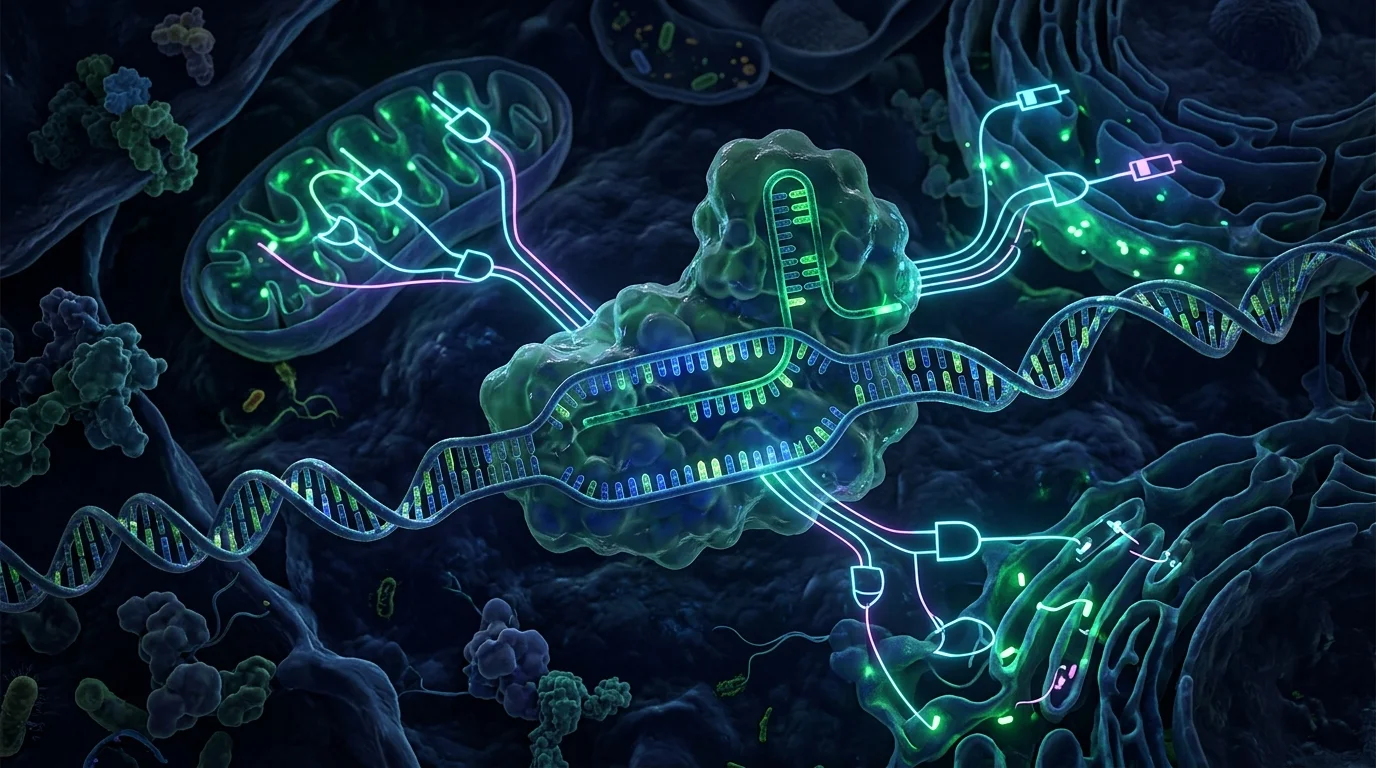 Abbildung: Der CRISPR-Cas9-Molekularkomplex beim präzisen DNA-Refactoring neben synthetischen zellulären Logikgattern.
Off-Target-Effekte: Biologische Regressions-Bugs
Wer in einem großen Softwareprojekt unvorsichtig mit regulären Ausdrücken global ersetzt, riskiert, unbeabsichtigt Variablen gleichen Namens in anderen Modulen zu überschreiben. In der Biologie nennen wir dies einen Off-Target-Effekt.
Wenn die gRNA anstelle von 100 % eine Sequenzhomologie von 85–90 % an einer anderen Genomstelle toleriert und Cas9 dort schneidet, kann dies kritische Regressions-Bugs (wie das unbeabsichtigte Stilllegen eines Tumorsuppressorgens) verursachen. Neuere Verfahren wie Base-Editing und Prime-Editing minimieren dieses Risiko, indem sie gezielt Basen umschreiben, ohne Doppelstrangbrüche zu erzeugen.
Biologische Logikgatter (Bio-Circuits)
Synthetische Biologie beschränkt sich nicht auf das Beheben von Erbkrankheiten; sie entwirft neuartige Schaltkreise direkt in der lebenden Zelle. Was Elektroingenieure mit Transistoren in Silizium ätzen, implementieren Bioingenieure über Genregulationsnetzwerke (Gene Regulatory Networks - GRNs):
Die Promotorregion eines Gens und die daran bindenden Transkriptionsfaktoren steuern den Transkriptionsfluss analog zum Gate eines MOSFET-Transistors:
- NOT-Gatter (Inverter): Ist Molekül A präsent ($\text{Eingang} = 1$), bindet ein Repressor-Protein an den Promotor und blockiert die Genexpression ($\text{Ausgang} = 0$). Fehlt Molekül A, wird das Reporterprotein (z. B. GFP) synthetisiert ($\text{Ausgang} = 1$).
- AND-Gatter: Ein Gen wird nur dann transkribiert, wenn sowohl Molekül A als auch Molekül B gleichzeitig anwesend sind. Beispiel: “Synthetisiere das zytotoxische Therapeutikum ($\text{Ausgang} = 1$) GENAU DANN, WENN Hypoxie vorliegt ($\text{Eingang}_1 = 1$) UND ein spezifischer Tumormarker detektiert wird ($\text{Eingang}_2 = 1$).” Dies bildet das Fundament programmierbarer Zelltherapien.
- OR-Gatter: Ein redundanter Schaltkreis, bei dem die Aktivierung eines beliebigen von zwei Promotoren die Proteinsynthese initiiert.
Silizium-Determinismus vs. stochastische Biologie
Schreibt man in C++ auf einem Mikrocontroller if (A && B), schaltet der Ausgang bei erfüllter Bedingung deterministisch auf High (3,3 V). Silizium ist deterministisch; Elektronen fließen in Kupferbahnen mit berechenbarer Physik.
Das Innere einer Zelle ist jedoch keine starre Leiterplatte, sondern eine heiße, hochkonzentrierte wässrige Lösung, in der Moleküle via Brownscher Bewegung zufällig kollidieren. Biologische Schaltkreise sind stochastisch (probabilistisch). Ein biologisches AND-Gatter liefert selbst bei aktiven Eingängen keinen scharfen binären Spannungssprung, sondern eine Wahrscheinlichkeitsverteilung. Die ingenieurtechnische Herausforderung der synthetischen Biologie besteht darin, trotz dieses thermischen Rauschens robuste zelluläre Zustandsautomaten zu konstruieren.
Technischer Vergleich: Silizium-Computer vs. biologische Zellen
Vergleicht man Silizium-Prozessoren (Der Grundstein des digitalen Universums: Transistorkriege) mit den Informationsverarbeitungseinheiten der Natur, zeigt sich ein bemerkenswertes Bild:
| Parameter | Silizium-Computer (CPU / MCU) | Biologische Zellen (Lebende Systeme) |
|---|---|---|
| Logische Basis | Binär (0, 1) | Quaternär (A, T, G, C) |
| Schaltelement | Transistor (FinFET / GAAFET) | Promotoren & Transkriptionsfaktoren |
| Taktfrequenz | Sehr hoch ($\text{GHz}$ — Milliarden Operationen/s) | Sehr niedrig ($\text{mHz}$ – $\text{Hz}$ — Sekunden bis Minuten) |
| Parallelität | Begrenzt durch physische Kerne | Massiv (Milliarden Moleküle reagieren simultan) |
| Energieverbrauch | Hoch ($\text{Watt}$ bis $\text{Kilowatt}$, erhebliche Abwärme) | Ultra-niedrig ($\sim\text{Pikowatt}$/Zelle, ATP-basiert) |
| Betriebsmodus | Deterministisch und digital | Stochastisch (Probabilistisch) & Analog-Digital-Hybrid |
| Fehlertoleranz & Reparatur | Gering (Defekter Transistor kann Chip zerstören) | Extrem hoch (DNA-Reparaturenzyme, Autophagie, Selbstreplikation) |
Fazit: Den Code des Lebens refaktorisieren
Über Jahrhunderte war die Biologie eine rein beschreibende Wissenschaft; wir dokumentierten und analysierten den gewachsenen Legacy-Code der Natur mittels Reverse Engineering.
Mit dem Bioingenieurwesen und der Synthetischen Biologie betreten wir eine neue Ära: Wir sind nicht mehr nur passive Beobachter, sondern Systemarchitekten, die Stoffwechselwege optimieren, vererbbare Bugs mittels CRISPR patchen und lebenden Zellen völlig neuartige logische Funktionen implementieren.
Beim Refactoring einer Codebasis mit vier Milliarden Jahren Entwicklungsgeschichte ist Respekt vor unerwarteten Seiteneffekten geboten. Dennoch steht fest: Die bahnbrechendste Software des 21. Jahrhunderts wird nicht ausschließlich auf Siliziumchips laufen – sie wird in lebenden Zellen kompiliert und ausgeführt.
Autor: Kerem Uysal — Gründer, Tech&Lab
Kontakt: info@keremuysal.com | info@techandlab.com